 Nano-Micro Letters
Ziwei Huo, Nuo Xu, Yixuan Fu, Rui Gu, Chao Liu, Zhong Lin Wang*, Qijun Sun*
Nano-Micro Letters (2027)19: 55
https://doi.org/10.1007/s40820-026-02346-x
1. 自供电柔性贴片,感知“无声”:构建了基于摩擦纳米发电机的柔性电子皮肤贴片,采用FEP/Nylon接触-分离传感结构、银织物电极和Kapton封装,贴附于口轮匝肌、降口角肌与颊肌交汇处,无需外部供电即可将唇/面部肌肉运动转化为可读电信号。
2. 四层CNN算法高精度解码:提出四层卷积神经网络,在15类词、每类约200个样本、共3000个样本的数据集上实现98.75%的识别准确率;12次重复实验平均准确率98.892%,跨被试平均97.15%,跨天测试保持97.6%以上,长句平均识别97.3%。
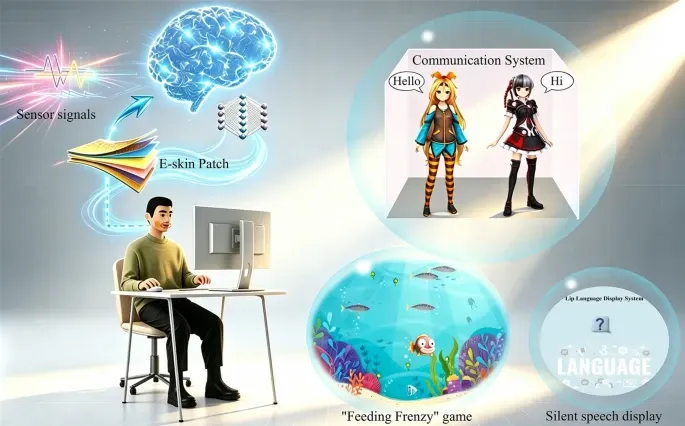
3. 多场景HMI/VR应用落地:演示了无声语音显示系统、唇部控制的“Feeding Frenzy”互动游戏和VR虚拟对话平台;结合时频分析与DTW距离验证了无声/有声语音信号的一致性与类间可分性。
无声语音解码,也就是通常所说的“唇读”,为喉部、舌部功能障碍人群以及强噪声、隐私敏感等不便发声场景提供了一种非接触式沟通可能。然而,现有技术路线仍面临明显瓶颈:视觉采集方案容易受光照、遮挡和隐私问题影响;传统可穿戴方案往往依赖外部电源、系统复杂;同时,个体唇动差异大、识别类别增多后信号易混淆,对特征提取和分类模型提出了更高要求。摩擦纳米发电机(TENG)具有低成本、自供电、柔性可贴合等优势,为构建舒适、隐私友好的口面部运动传感界面提供了新思路。在此背景下,如何把自供电柔性传感与高效深度学习解码结合起来,实现对大规模词汇的可靠识别,是推动无声语音交互走向实用的关键。
针对无声语音解码中“舒适采集难、外部供电依赖、个体差异大、类别混淆强”等问题,中国科学院北京纳米能源与系统研究所孙其君团队联合王中林教授团队等提出了一种自供电、低成本、柔性摩擦电E-skin贴片,并结合四层CNN实现无声语音识别与人机交互应用。器件以FEP为负摩擦层、Nylon为正摩擦层,银布作为输出电极,Kapton封装,并利用1 mm海绵垫形成稳定接触-分离间隙。贴片佩戴于口面部关键肌肉交汇处,捕获说话时唇/面部肌肉运动产生的摩擦电信号;信号经Arduino采集后传入训练好的CNN模型,完成特征提取、分类识别和语义输出。研究系统表征了器件结构、电学性能及唇动信号与有声语音的时频一致性,并在15类词数据集上实现98.75%的识别准确率。进一步集成HMI与VR技术,构建了实时唇语显示系统、口面控制互动游戏和VR虚拟对话平台,展示了该技术在辅助沟通、智能人机交互和沉浸式虚拟交流中的应用潜力。
I 一片“会读唇”的电子皮肤:系统设计与应用全景

图1. 基于摩擦电E-skin贴片的无声语音解码系统。
II 从唇动到电信号:接触-分离机理与高保真信号
在信号层面,对比了“hao jiu bu jian”“long time no see”等中英文短语在完整、分解和组合发音下的波形,发现E-skin输出与音节节奏高度对应;在0.5×、正常和1.5×语速下,信号峰值间距和幅值随发音速度规律变化。静音与有声发音的波形高度一致,Pearson相关系数达r=0.94(p<0.001);STFT时频分析与音频频谱在时频能量分布上高度吻合。DTW分析进一步表明,同类信号距离显著小于异类距离,15类词的DTW热图对角线距离明显更低,说明采集信号具有良好的重复性、稳定性和类间可分性。重复贴附、湿度与10,000次循环测试也验证了器件的机械可靠性和信号稳定性。

图2. E-skin贴片的工作机理与信号表征。
结果表明,随着卷积层数增加,分类准确率由1层的84.9%、2层的88.6%、3层的91.89%提升至4层的98.75%,说明多层结构能够提取更细粒度的局部波形特征和更高层语义表征。t-SNE可视化显示15类词在测试集上形成清晰聚类;ROC曲线和混淆矩阵进一步验证了模型在多类别任务中的判别能力。稳健性方面,12次不同随机种子重复实验的测试准确率为98.575%–99.671%,平均98.892%,标准差仅0.335%;跨被试平均准确率97.15%,跨天测试保持97.6%以上;五类长句(3–9词)端到端平均识别准确率97.3%。与SVM、随机森林、KNN、LSTM、GRU和Transformer相比,该四层CNN在准确率、训练效率和参数量之间取得了更优平衡。

图3. 基于CNN的多层神经网络结构与15类词分类结果。

图4. E-skin贴片控制的唇语显示系统与“Feeding Frenzy”游戏。
图5进一步展示了VR虚拟通信系统。用户佩戴E-skin贴片进行无声唇动,信号经Arduino串口传输至Unity平台,经预定义算法识别为文本后,再通过Unity TTS模块合成语音并驱动虚拟角色对话。论文以两个虚拟角色Amelia和Vanessa演示了多轮对话:Amelia无声询问“Hello! How was your trip during the holiday?”,Vanessa回答“It was amazing. Thank you for asking!”;随后继续“Wow! Where did you go?”与“I went to the mountains and a busy city.”。系统端到端延迟约80–110 ms,满足实时交互需求;连续对话中的DTW热图显示词内距离(0.5–2.1)显著低于词间距离(2.2–9.0),句子层面同样保持良好可分性,验证了连续会话场景下的信号稳定性与识别可靠性。

图5. E-skin贴片驱动的虚拟通信系统。
通过集成HMI与VR技术,研究构建了唇语显示、口面控制游戏和VR虚拟对话三类应用,展示了其在辅助沟通、智能人机交互、康复工程和沉浸式虚拟环境中的应用潜力。
未来,结合眼动追踪、脑机接口、TinyML边缘AI、器件微型化、高性能介电材料及大语言模型,有望进一步提升系统的便携性、实时性、隐私性和智能对话能力,为无障碍沟通与下一代人机交互提供新路径。

孙其君
本文通讯作者
中国科学院北京纳米能源与系统研究所 研究员
(1) 类脑器件/类脑计算;(2) 柔性半导体器件/电子皮肤传感器;(3)机器学习辅助的自驱动传感/人机交互/虚拟现实/数字孪生。
▍主要研究成果
中国科学院北京纳米能源与系统研究所-研究员,博士生导师,功能柔性电子课题组长,纳米光电测量平台主任,担任国家级项目课题负责人,入选中国科学院人才计划、北京市人才计划和北京市特聘专家,多次参加国家和省部级项目评审,国际工程心理学研究所(IIEP)特聘研究员。研究方向为新材料、半导体器件、电子皮肤传感器、新一代信息技术等,主要利用新型纳米材料构建柔性场效应晶体管,通过集成压电/摩擦电驱动单元,实现外部机械行为对电学特性调控,辅助机器学习对超低功耗人机交互、智能传感、人体健康监测、人工智能和感存算一体化芯片等领域做拓展应用研究。其团队科研人员20余名,承担多项国家和地方科研项目,在Nat. Mater., Nat. Commun., Sci. Adv., Chem. Rev., EES, Adv. Mater.等高水平期刊发表学术论文160余篇,申请专利30余项,多项成果入选首都前沿学术成果,自主研制国内首台(套)纳米发电机多通道测试系统-腾立方(TENG3)。担任 Nano-Micro Letters编委,The International Journal of Extreme Manufacturing副编辑,InfoMat, eScience等期刊青年编委。
▍Email:sunqijun@binn.cas.cn
撰稿:原文作者
如果文章对您有帮助,可以与别人分享!:Nano-Micro Letters » 中国科学院北京纳米能源所孙其君/王中林院士团队: 自供电摩擦电电子皮肤“读懂”无声唇语,开启人机交互与虚拟交流新范式
 西南交大杨维清/游世海等:厘米级 2D 铁电钙钛矿多晶晶圆,实现高效 X 射线探测
 南通大学麻伍军&东华大学朱美芳院士等综述:光辅助柔性储能器件的进展、挑战与未来方向
 韩国延世大学Min-gu Kim等: 一款3D集成多模态软触觉界面同步感知物体结构形貌与热分布
 南洋理工徐梽川院士综述: 面向无负极碱金属电池实用化的集流体设计策略